PHP の file_get_contents や curl でページを取ったのに、ブラウザーで見えている一覧がソースに入っていない。そんな経験はありませんか。最近のサイトは、ページを開いたあとに JavaScript がデータを取りに行って(Ajax)、一覧を組み立てていることが多いからです。
この記事では、ラズパイに自分だけのスクレイピングの環境を作ります。画面から URL を登録しておくと、ラズパイがブラウザー(Chromium)で開いて、JavaScript が動いたあとの HTML まで、完全自動で取得してデータベースに保存します。ページが裏で読んでいるデータ(JSON)も一緒に保存するので、「データがどこから来ているか」まで分かります。
この記事の前にできていること
- 第 1〜3 回:ラズパイを始める・OS を書き込む・PC から SSH でつなぐ
- 第 4 回:Claude(AI)にラズパイを操作させる(なくても進められます)
基本の環境づくり(第 1〜9 回)のうち、NAS やバックアップの回(第 5〜9 回)は、この記事にはいりません。第 3 回まで済んでいれば始められます。
この記事でできるようになること
- ラズパイの画面(家の LAN の中だけ)から URL を登録すると、決めた間隔で自動で取得する
- 「最初に届いた HTML(file_get_contents と同じ)」と「JavaScript が動いたあとの HTML」の両方を保存して、違いを見られる
- ページが裏で読んでいる通信(Ajax の JSON)の URL と内容も保存する
先に:取ってよいページの決まり
スクレイピングは、相手のサイトに負担をかけることがあります。この環境は、次の決まりで使う前提で作りました。
相手にやさしく使う
- サイトの利用規約で、自動での取得が禁止されていないかを先に読む
- robots.txt で「取らないで」と書かれている URL は、プログラムが自動で取らない(robots.txt が 401・403 で読めないサイトも、取らない。robots.txt がない〔404〕サイトは、決まりなしとして取る)
- ログインが要るページ・ボット対策の確認の画面が出るページは取らない(突破はしない)
- 同じサイトは 3 分あけて 1 件ずつ。403・429 などが返ったら、そのサイトは 6 時間止める
- 画像・動画・フォントは読まない(相手と自分の通信を減らす)
この記事の試しでは、スクレイピングの練習用に公開されているサイト quotes.toscrape.com を使っています。自分で試すときも、まずはここで動きを見てください。
仕組みの流れ
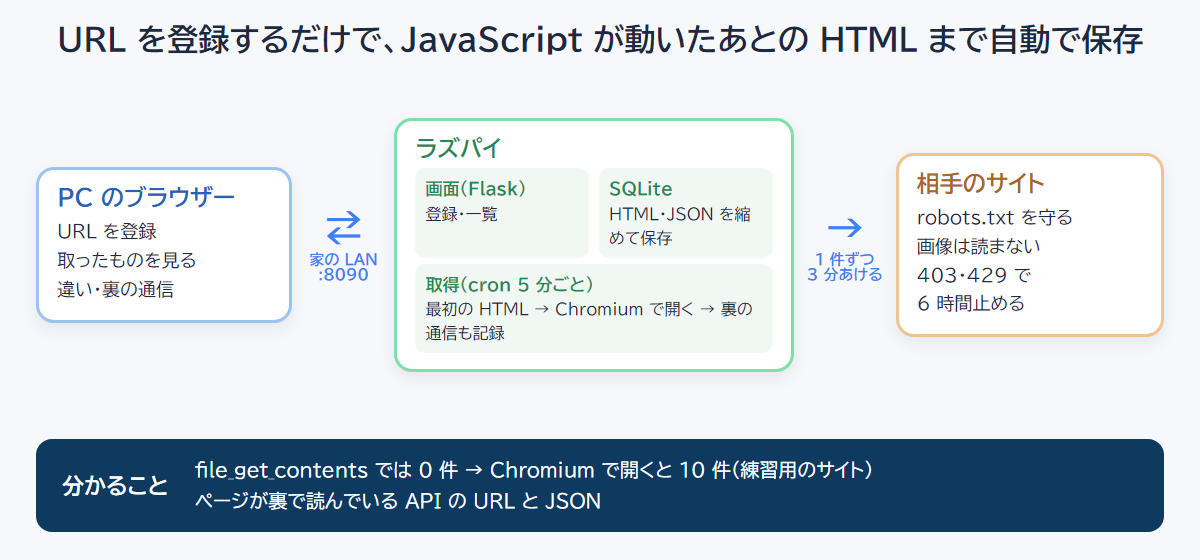
- ① 画面(Flask)から URL を登録する。データベース(SQLite)に保存される
- ② 5 分ごとに cron が取得のプログラムを起こし、取る時期が来た URL を 1 件ずつ取る
- ③ まず「最初に届いた HTML」を取り、次に Chromium で開いて「JavaScript が動いたあとの HTML」と裏の通信を取る
- ④ 3 つとも縮めてデータベースに保存する。画面から、いつでも見られる
使うのは Python と、ブラウザーを動かすための Playwright、画面のための Flask です。データベースは SQLite(ファイル 1 つ)なので、MySQL などの準備はいりません。
用意するもの
- ラズパイ:家では Raspberry Pi 3 Model B(メモリー 1GB)で動いています。Chromium を動かすので、OS は 64 ビット版にします(第 2 回の Raspberry Pi OS Lite(64-bit))。
- microSD の空き:1GB ほど(Python の部品 187MB・Chromium 288MB・取ったデータ)。
- モニターやキーボードはいりません。PC から SSH でつないで作業します。
手順 A:Chromium に要る部品をインストールする
Chromium を動かすための部品を、OS にインストールします。管理者の権限(sudo)が要るので、パスワードを聞かれたら、ラズパイのユーザーのパスワードを入力します。
sudo apt-get update
sudo apt-get install -y python3-venv libatk1.0-0t64 libxcomposite1 libxdamage1 libxfixes3 libxrandr2 libgbm1 libxkbcommon0 libatspi2.0-0t64
家のラズパイ(Debian 13・trixie)では、この 8 つが足りませんでした。前のバージョンの Raspberry Pi OS(bookworm)では、名前の最後の t64 を外します(例:libatk1.0-0・libatspi2.0-0)。足りないと、手順 D で「Host system is missing dependencies」と出て、足りない部品の名前が表示されます。そのときは、表示された名前を同じように sudo apt-get install -y でインストールします。
手順 B:Python の部品と Chromium をインストールする
ラズパイの中のほかの Python と混ざらないように、~/scraper の中に専用の場所(仮想環境)を作って、そこにインストールします。
mkdir -p ~/scraper/data && cd ~/scraper
python3 -m venv venv
venv/bin/pip install playwright flask
venv/bin/playwright install --only-shell chromium- 最後の行の
--only-shellで、画面を出さない用の Chromium(headless shell)だけをインストールします。この仕組みは画面を出さないので、これで足ります。家で試したところ、288MB・32 秒でした。 --only-shellを付けないと、画面を出す用の Chromium も一緒にインストールされて、697MB になりました(家のラズパイは最初にこちらでインストールしてしまいました)。- 家の環境のバージョン:Python 3.13・Playwright 1.65・Flask 3.1。
手順 C:3 つのファイルを設置する
~/scraper に、次の 3 つのファイルを設置します。それぞれ nano ~/scraper/ファイルの名前 で開いて、貼り付けて保存します(Ctrl+O で保存、Ctrl+X で閉じる)。
1. db.py:データベース
登録した URL・取った回・裏の通信の 3 つの表を、SQLite のファイル(~/scraper/data/scraper.db)に作ります。HTML は zlib で縮めて保存するので、SD カードの容量と書き込みを減らせます。
# ~/scraper/db.py:保存先(SQLite)
# HTML と応答は zlib で縮めて保存する(SD の容量と書き込みを減らす)
import os
import sqlite3
import zlib
from datetime import datetime
DB_PATH = os.environ.get("SCRAPER_DB", os.path.expanduser("~/scraper/data/scraper.db"))
SCHEMA = """
CREATE TABLE IF NOT EXISTS targets (
  id INTEGER PRIMARY KEY,
  url TEXT NOT NULL UNIQUE,
  label TEXT NOT NULL DEFAULT '',
  interval_min INTEGER NOT NULL DEFAULT 1440,   -- 何分ごとに取るか(既定は 1 日)
  wait_selector TEXT NOT NULL DEFAULT '',       -- これが出るまで待つ(空なら通信が落ち着くまで)
  enabled INTEGER NOT NULL DEFAULT 1,
  created_at TEXT NOT NULL,
  last_fetched_at TEXT,
  paused_until TEXT,                            -- 429・403 などで止めている期限
  note TEXT NOT NULL DEFAULT ''
);
CREATE TABLE IF NOT EXISTS fetches (
  id INTEGER PRIMARY KEY,
  target_id INTEGER NOT NULL REFERENCES targets(id),
  fetched_at TEXT NOT NULL,
  ok INTEGER NOT NULL,
  raw_status INTEGER, raw_ms INTEGER, raw_bytes INTEGER, raw_html BLOB,
  dom_status INTEGER, dom_ms INTEGER, dom_bytes INTEGER, dom_html BLOB,
  xhr_count INTEGER NOT NULL DEFAULT 0,
  error TEXT NOT NULL DEFAULT ''
);
CREATE INDEX IF NOT EXISTS fetches_target ON fetches(target_id, fetched_at);
CREATE TABLE IF NOT EXISTS xhrs (
  id INTEGER PRIMARY KEY,
  fetch_id INTEGER NOT NULL REFERENCES fetches(id),
  url TEXT NOT NULL, method TEXT NOT NULL, status INTEGER,
  content_type TEXT NOT NULL DEFAULT '',
  bytes INTEGER NOT NULL DEFAULT 0,
  body BLOB                                     -- 1MB までの JSON・テキストだけ
);
CREATE INDEX IF NOT EXISTS xhrs_fetch ON xhrs(fetch_id);
"""
def now():
    return datetime.now().strftime("%Y-%m-%d %H:%M:%S")
def connect():
    os.makedirs(os.path.dirname(DB_PATH), exist_ok=True)
    con = sqlite3.connect(DB_PATH, timeout=30)
    con.row_factory = sqlite3.Row
    con.execute("PRAGMA journal_mode=WAL")
    con.execute("PRAGMA foreign_keys=ON")
    con.executescript(SCHEMA)
    return con
def pack(text):
    if text is None:
        return None
    if isinstance(text, str):
        text = text.encode("utf-8", "replace")
    return zlib.compress(text, 6)
def unpack(blob):
    if blob is None:
        return ""
    return zlib.decompress(blob).decode("utf-8", "replace")
2. fetcher.py:取得のプログラム
取る時期が来た URL を、1 件ずつ取って保存します。相手にやさしくする決まりは、頭の数字で変えられます。
ここだけ自分の環境に変える(fetcher.py の頭)
MAX_PER_RUN:1 回(5 分ごと)に取る数。メモリーの少ないラズパイは 3 のままがおすすめHOST_GAP_MIN:同じサイトをあける分。短くしすぎないKEEP_FETCHES:URL ごとに残す回数(古い回から消える)QUIET:動かさない時間。ほかの処理(第 6 回のバックアップなど)の時間に合わせる
#!/usr/bin/env python3
# ~/scraper/fetcher.py:取る時期が来た URL を、1 件ずつ取って保存する
# cron から 5 分ごとに呼ぶ。手動で 1 件だけ取るときは --id 番号
# 相手にやさしく:同じサイトは HOST_GAP_MIN 分あける・robots.txt を守る・429/403 が返ったらしばらく止める
import argparse
import fcntl
import os
import sys
import time
import urllib.error
import urllib.request
import urllib.robotparser
from datetime import datetime, timedelta
from urllib.parse import urlsplit
import db
UA = "Mozilla/5.0 (X11; Linux aarch64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/142.0.0.0 Safari/537.36"
MAX_PER_RUN = 3          # 1 回に取る数
HOST_GAP_MIN = 3         # 同じサイトをあける分
PAUSE_HOURS = 6          # 429・403 などのあと止める時間
KEEP_FETCHES = 30        # URL ごとに残す回数
XHR_BODY_MAX = 1_000_000
QUIET = ("02:25", "03:15")  # 夜のバックアップの時間は動かさない
LOG = os.path.expanduser("~/scraper/data/fetch.log")
LOCK = os.path.expanduser("~/scraper/data/fetch.lock")
STOP_STATUS = {403, 429, 503}
def log(msg):
    with open(LOG, "a", encoding="utf-8") as f:
        f.write(f"{db.now()}\t{msg}\n")
def host(url):
    return urlsplit(url).netloc.lower()
_robots = {}
def robots_ok(url):
    p = urlsplit(url)
    base = f"{p.scheme}://{p.netloc}"
    if base not in _robots:
        rp = urllib.robotparser.RobotFileParser()
        rp.set_url(base + "/robots.txt")
        try:
            req = urllib.request.Request(base + "/robots.txt", headers={"User-Agent": UA})
            with urllib.request.urlopen(req, timeout=15) as r:
                rp.parse(r.read(200_000).decode("utf-8", "replace").splitlines())
        except urllib.error.HTTPError as e:
            # 401・403 は「全部取らない」・404 などほかの 4xx は「決まりなし」・5xx は今回は取らない
            # (Python の RobotFileParser.read() と同じ決まり。何も決めないと can_fetch() が False になる)
            if e.code in (401, 403):
                rp.disallow_all = True
            elif 400 <= e.code < 500:
                rp.allow_all = True
            else:
                rp.disallow_all = True
        except Exception:
            rp.parse([])  # 読めないときは、決まりなしとして扱う
        _robots[base] = rp
    return _robots[base].can_fetch("*", url)
def fetch_raw(url):
    """file_get_contents と同じ:最初に届いた HTML だけ"""
    t = time.time()
    req = urllib.request.Request(url, headers={"User-Agent": UA, "Accept-Language": "ja,en;q=0.8"})
    try:
        with urllib.request.urlopen(req, timeout=30) as r:
            body = r.read(5_000_000)
            status = r.status
            charset = r.headers.get_content_charset() or "utf-8"
    except urllib.error.HTTPError as e:
        return e.code, int((time.time() - t) * 1000), ""
    return status, int((time.time() - t) * 1000), body.decode(charset, "replace")
def fetch_dom(browser, url, wait_selector):
    """Chromium で開いて、JavaScript が動いたあとの DOM と、裏の通信(xhr・fetch)を取る"""
    xhrs = []
    ctx = browser.new_context(user_agent=UA, locale="ja-JP", viewport={"width": 1280, "height": 900})
    page = ctx.new_page()
    # 画像・動画・フォントは読まない(相手と自分の負担を減らす)
    page.route("**/*", lambda route: route.abort() if route.request.resource_type in ("image", "media", "font") else route.continue_())
    def on_response(res):
        req = res.request
        if req.resource_type not in ("xhr", "fetch"):
            return
        ct = res.headers.get("content-type", "")
        body = None
        size = 0
        try:
            if any(k in ct for k in ("json", "text", "javascript", "xml")):
                b = res.body()
                size = len(b)
                if size <= XHR_BODY_MAX:
                    body = b
        except Exception:
            pass
        xhrs.append({"url": res.url, "method": req.method, "status": res.status, "ct": ct[:100], "bytes": size, "body": body})
    page.on("response", on_response)
    t = time.time()
    try:
        res = page.goto(url, wait_until="domcontentloaded", timeout=45_000)
        status = res.status if res else None
        try:
            if wait_selector:
                page.wait_for_selector(wait_selector, timeout=20_000)
            else:
                page.wait_for_load_state("networkidle", timeout=15_000)
        except Exception:
            pass  # 待ちきれなくても、その時点の DOM を保存する
        html = page.content()
    finally:
        ms = int((time.time() - t) * 1000)
        ctx.close()
    return status, ms, html, xhrs
def due_targets(con, only_id=None):
    if only_id:
        return con.execute("SELECT * FROM targets WHERE id=?", (only_id,)).fetchall()
    n = db.now()
    rows = con.execute(
        """SELECT * FROM targets WHERE enabled=1 AND (paused_until IS NULL OR paused_until < ?)
           AND (last_fetched_at IS NULL OR datetime(last_fetched_at, '+' || interval_min || ' minutes') <= ?)
           ORDER BY last_fetched_at IS NOT NULL, last_fetched_at""", (n, n)).fetchall()
    # 同じサイトは 1 回に 1 件・前に取ってから HOST_GAP_MIN 分あける
    recent = {}
    for r in con.execute("SELECT url, last_fetched_at FROM targets WHERE last_fetched_at IS NOT NULL"):
        h = host(r["url"])
        recent[h] = max(recent.get(h, ""), r["last_fetched_at"])
    limit = (datetime.now() - timedelta(minutes=HOST_GAP_MIN)).strftime("%Y-%m-%d %H:%M:%S")
    out, seen = [], set()
    for r in rows:
        h = host(r["url"])
        if h in seen or recent.get(h, "") > limit:
            continue
        seen.add(h)
        out.append(r)
        if len(out) >= MAX_PER_RUN:
            break
    return out
def save(con, target, raw, dom, xhrs, error):
    ok = 1 if (not error and dom and dom[2]) else 0
    cur = con.execute(
        """INSERT INTO fetches (target_id, fetched_at, ok, raw_status, raw_ms, raw_bytes, raw_html,
           dom_status, dom_ms, dom_bytes, dom_html, xhr_count, error) VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)""",
        (target["id"], db.now(), ok,
         raw[0] if raw else None, raw[1] if raw else None, len(raw[2].encode()) if raw else None, db.pack(raw[2]) if raw else None,
         dom[0] if dom else None, dom[1] if dom else None, len(dom[2].encode()) if dom else None, db.pack(dom[2]) if dom else None,
         len(xhrs), error[:500]))
    fid = cur.lastrowid
    for x in xhrs:
        con.execute("INSERT INTO xhrs (fetch_id, url, method, status, content_type, bytes, body) VALUES (?,?,?,?,?,?,?)",
                    (fid, x["url"][:2000], x["method"], x["status"], x["ct"], x["bytes"], db.pack(x["body"]) if x["body"] is not None else None))
    con.execute("UPDATE targets SET last_fetched_at=? WHERE id=?", (db.now(), target["id"]))
    # 429・403・503 が返ったら、そのサイトをしばらく止める
    codes = {c for c in ((raw or [None])[0], (dom or [None])[0]) if c}
    if codes & STOP_STATUS:
        until = (datetime.now() + timedelta(hours=PAUSE_HOURS)).strftime("%Y-%m-%d %H:%M:%S")
        con.execute("UPDATE targets SET paused_until=?, note=? WHERE id=?",
                    (until, f"{db.now()} に {sorted(codes & STOP_STATUS)} が返ったので {PAUSE_HOURS} 時間止めた", target["id"]))
    # 古い回を消す(URL ごとに新しい KEEP_FETCHES 回を残す)
    old = [r[0] for r in con.execute("SELECT id FROM fetches WHERE target_id=? ORDER BY fetched_at DESC LIMIT -1 OFFSET ?", (target["id"], KEEP_FETCHES))]
    for oid in old:
        con.execute("DELETE FROM xhrs WHERE fetch_id=?", (oid,))
        con.execute("DELETE FROM fetches WHERE id=?", (oid,))
    con.commit()
    return fid, ok
def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--id", type=int, help="この番号の URL だけを今すぐ取る")
    args = ap.parse_args()
    os.makedirs(os.path.dirname(LOG), exist_ok=True)
    hm = datetime.now().strftime("%H:%M")
    if not args.id and QUIET[0] <= hm < QUIET[1]:
        return 0
    lockf = open(LOCK, "w")
    try:
        fcntl.flock(lockf, fcntl.LOCK_EX | fcntl.LOCK_NB)  # 前の回が動いていたら何もしない
    except BlockingIOError:
        return 0
    con = db.connect()
    targets = due_targets(con, args.id)
    if not targets:
        return 0
    from playwright.sync_api import sync_playwright
    with sync_playwright() as pw:
        browser = None
        for i, t in enumerate(targets):
            if i:
                time.sleep(5)
            url = t["url"]
            raw = dom = None
            xhrs, error = [], ""
            try:
                if not robots_ok(url):
                    error = "robots.txt で取らないように決められている"
                else:
                    raw = fetch_raw(url)
                    if raw[0] in STOP_STATUS:
                        error = f"最初の HTML で {raw[0]} が返った(ブラウザーでは開かない)"
                    else:
                        if browser is None:
                            browser = pw.chromium.launch(headless=True, args=["--disable-dev-shm-usage"])
                        dom_status, dom_ms, html, xhrs = fetch_dom(browser, url, t["wait_selector"])
                        dom = (dom_status, dom_ms, html)
            except Exception as e:
                error = f"{type(e).__name__}: {e}"[:500]
            fid, ok = save(con, t, raw, dom, xhrs, error)
            log(f"{'OK' if ok else 'NG'}\tid={t['id']}\tfetch={fid}\traw={raw[0] if raw else '-'}/{raw[1] if raw else '-'}ms"
                f"\tdom={dom[0] if dom else '-'}/{dom[1] if dom else '-'}ms\txhr={len(xhrs)}\t{url}\t{error}")
        if browser:
            browser.close()
    return 0
if __name__ == "__main__":
    sys.exit(main())
3. app.py:URL の登録と、取ったものを見る画面
Flask の画面です。SCRAPER_PORT の 8090 は、ブラウザーで開くときの番号です。ほかで使っていれば変えます。
#!/usr/bin/env python3
# ~/scraper/app.py:URL の登録と、取ったものを見る画面(家の LAN の中だけ・8090 番)
# 取った HTML は、この画面の中で HTML として表示しない(相手のページのスクリプトが動かないよう、テキストで出す)
import difflib
import os
import re
from urllib.parse import urlsplit
from flask import Flask, Response, abort, redirect, render_template_string, request, url_for
import db
app = Flask(__name__)
HOST = os.environ.get("SCRAPER_HOST", "0.0.0.0")
PORT = int(os.environ.get("SCRAPER_PORT", "8090"))
BASE = """<!doctype html><html lang="ja"><head><meta charset="utf-8">
<meta name="viewport" content="width=device-width,initial-scale=1"><title>{{ title }}|スクレイピング</title>
<style>
:root{--bg:#0d1520;--card:#142131;--line:#22364d;--text:#d6e3f0;--muted:#8aa0b8;--accent:#3ec7ff;--ok:#5fd39a;--ng:#ff8a7a;--warn:#f0b46a}
*{box-sizing:border-box}body{margin:0;background:var(--bg);color:var(--text);font:15px/1.6 system-ui,"BIZ UDPGothic","Meiryo",sans-serif}
a{color:var(--accent)}header{border-bottom:2px solid var(--accent);padding:12px 16px;display:flex;gap:16px;align-items:center}
header b{letter-spacing:.08em}main{max-width:1100px;margin:0 auto;padding:16px}
.card{background:var(--card);border:1px solid var(--line);border-radius:8px;padding:14px 16px;margin:0 0 16px}
h1{font-size:20px;margin:0 0 12px}h2{font-size:16px;margin:0 0 10px;color:var(--accent)}
table{width:100%;border-collapse:collapse;font-size:14px}th,td{border-bottom:1px solid var(--line);padding:6px 8px;text-align:left;vertical-align:top}
th{color:var(--muted);font-weight:600}.wrap{overflow-x:auto}
input,select{background:#0b121b;color:var(--text);border:1px solid var(--line);border-radius:6px;padding:7px 9px;font:inherit;width:100%}
label{display:block;margin:0 0 10px;color:var(--muted);font-size:13px}label span{display:block;margin-bottom:3px}
.grid{display:grid;grid-template-columns:2fr 1fr;gap:0 14px}@media(max-width:700px){.grid{grid-template-columns:1fr}}
button{background:var(--accent);color:#04131d;border:0;border-radius:6px;padding:8px 16px;font:inherit;font-weight:700;cursor:pointer}
button.sub{background:transparent;color:var(--accent);border:1px solid var(--accent);padding:4px 10px;font-weight:600}
button.del{background:transparent;color:var(--ng);border:1px solid var(--ng);padding:4px 10px}
form.inline{display:inline}.ok{color:var(--ok)}.ng{color:var(--ng)}.warn{color:var(--warn)}.muted{color:var(--muted)}
pre{background:#0b121b;border:1px solid var(--line);border-radius:6px;padding:10px;overflow:auto;font:12px/1.5 Consolas,monospace;white-space:pre-wrap;word-break:break-all;max-height:70vh}
.add{color:var(--ok)}.rm{color:var(--ng)}.url{word-break:break-all}
</style></head><body><header><b>SCRAPER</b><a href="/">URL の一覧</a></header><main>{{ body|safe }}</main>
<script>
document.addEventListener('submit',function(e){var m=e.target.getAttribute('data-confirm');if(m&&!window.confirm(m))e.preventDefault();});
</script></body></html>"""
def page(page_title, tpl, **kw):
    body = render_template_string(tpl, **kw)
    return render_template_string(BASE, title=page_title, body=body)
@app.before_request
def same_origin_only():
    # 書き込み(POST)は、この画面から送ったものだけ受け付ける(名前と番号で比べる。前に https の中継があっても通るように)
    if request.method == "POST":
        origin = request.headers.get("Origin") or request.headers.get("Referer") or ""
        if urlsplit(origin).netloc != request.host:
            abort(403)
def kb(n):
    if n is None:
        return "-"
    return f"{n / 1024:,.1f}KB" if n < 1024 * 1024 else f"{n / 1024 / 1024:,.2f}MB"
app.jinja_env.filters["kb"] = kb
INDEX = """
<div class="card"><h1>URL を登録する</h1>
<form method="post" action="/add">
<div class="grid"><label><span>URL(http・https)</span><input name="url" required placeholder="https://example.com/page"></label>
<label><span>名前(なくてもよい)</span><input name="label"></label></div>
<div class="grid"><label><span>この部品が出るまで待つ(CSS セレクター・なくてもよい)</span><input name="wait_selector" placeholder=".item など"></label>
<label><span>取る間隔</span><select name="interval_min">
<option value="60">1 時間ごと</option><option value="360">6 時間ごと</option><option value="1440" selected>1 日ごと</option><option value="10080">1 週間ごと</option></select></label></div>
<button>登録する</button> <span class="muted">登録すると、5 分以内に最初の 1 回を取ります(夜 2:25〜3:15 は休み)</span>
</form></div>
<div class="card"><h2>登録した URL({{ rows|length }} 件)</h2><div class="wrap"><table>
<tr><th>名前・URL</th><th>間隔</th><th>最後に取った</th><th>結果</th><th></th></tr>
{% for r in rows %}<tr>
<td><a href="/t/{{ r.id }}">{{ r.label or '(名前なし)' }}</a><div class="url muted">{{ r.url }}</div>
{% if r.paused_until %}<div class="warn">止めている:{{ r.paused_until }} まで</div>{% endif %}{% if not r.enabled %}<div class="warn">無効</div>{% endif %}</td>
<td>{{ intervals.get(r.interval_min, r.interval_min ~ ' 分') }}</td><td>{{ r.last_fetched_at or '-' }}</td>
<td>{% if r.last_ok is none %}-{% elif r.last_ok %}<span class="ok">OK</span>{% else %}<span class="ng">NG</span>{% endif %}
{% if r.last_xhr %}<div class="muted">通信 {{ r.last_xhr }} 件</div>{% endif %}</td>
<td><form class="inline" method="post" action="/t/{{ r.id }}/soon"><button class="sub">次の回で取る</button></form></td></tr>
{% else %}<tr><td colspan="5" class="muted">まだありません</td></tr>{% endfor %}
</table></div></div>"""
INTERVALS = {60: "1 時間ごと", 360: "6 時間ごと", 1440: "1 日ごと", 10080: "1 週間ごと"}
@app.get("/")
def index():
    con = db.connect()
    rows = con.execute("""SELECT t.*, (SELECT ok FROM fetches f WHERE f.target_id=t.id ORDER BY fetched_at DESC LIMIT 1) last_ok,
        (SELECT xhr_count FROM fetches f WHERE f.target_id=t.id ORDER BY fetched_at DESC LIMIT 1) last_xhr
        FROM targets t ORDER BY t.id DESC""").fetchall()
    return page("URL の一覧", INDEX, rows=rows, intervals=INTERVALS)
@app.post("/add")
def add():
    url = (request.form.get("url") or "").strip()
    p = urlsplit(url)
    if p.scheme not in ("http", "https") or not p.netloc:
        return page("登録できません", '<div class="card ng">http か https の URL を入れてください。<a href="/">戻る</a></div>'), 400
    try:
        interval = int(request.form.get("interval_min") or 1440)
    except ValueError:
        interval = 1440
    interval = interval if interval in INTERVALS else 1440
    con = db.connect()
    try:
        con.execute("INSERT INTO targets (url, label, interval_min, wait_selector, created_at) VALUES (?,?,?,?,?)",
                    (url, (request.form.get("label") or "").strip()[:100], interval,
                     (request.form.get("wait_selector") or "").strip()[:200], db.now()))
        con.commit()
    except db.sqlite3.IntegrityError:
        return page("登録できません", '<div class="card ng">この URL はもう登録されています。<a href="/">戻る</a></div>'), 400
    return redirect("/")
def target_or_404(con, tid):
    t = con.execute("SELECT * FROM targets WHERE id=?", (tid,)).fetchone()
    if not t:
        abort(404)
    return t
@app.post("/t/<int:tid>/soon")
def soon(tid):
    con = db.connect()
    target_or_404(con, tid)
    # 403・429 で止めている期間(paused_until)は消さない(相手にやさしく・止めを外したいときは、時間がたつのを待つ)
    con.execute("UPDATE targets SET last_fetched_at=NULL WHERE id=?", (tid,))
    con.commit()
    return redirect(request.referrer or "/")
@app.post("/t/<int:tid>/toggle")
def toggle(tid):
    con = db.connect()
    target_or_404(con, tid)
    con.execute("UPDATE targets SET enabled=1-enabled WHERE id=?", (tid,))
    con.commit()
    return redirect(url_for("target", tid=tid))
@app.post("/t/<int:tid>/delete")
def delete(tid):
    con = db.connect()
    target_or_404(con, tid)
    con.execute("DELETE FROM xhrs WHERE fetch_id IN (SELECT id FROM fetches WHERE target_id=?)", (tid,))
    con.execute("DELETE FROM fetches WHERE target_id=?", (tid,))
    con.execute("DELETE FROM targets WHERE id=?", (tid,))
    con.commit()
    return redirect("/")
TARGET = """
<div class="card"><h1>{{ t.label or '(名前なし)' }}</h1><div class="url"><a href="{{ t.url }}" rel="noopener noreferrer" target="_blank">{{ t.url }}</a></div>
<p class="muted">間隔:{{ intervals.get(t.interval_min, t.interval_min) }}・待つ部品:{{ t.wait_selector or '(なし・通信が落ち着くまで)' }}・登録:{{ t.created_at }}
{% if t.note %}<br><span class="warn">{{ t.note }}</span>{% endif %}</p>
<form class="inline" method="post" action="/t/{{ t.id }}/soon"><button class="sub">次の回で取る</button></form>
<form class="inline" method="post" action="/t/{{ t.id }}/toggle"><button class="sub">{{ '無効にする' if t.enabled else '有効にする' }}</button></form>
<form class="inline" method="post" action="/t/{{ t.id }}/delete" data-confirm="この URL と、取ったものを全部消します。よいですか?"><button class="del">消す</button></form></div>
<div class="card"><h2>取った回(新しい順・30 回まで残す)</h2><div class="wrap"><table>
<tr><th>日時</th><th>結果</th><th>最初の HTML</th><th>動いたあとの DOM</th><th>通信</th></tr>
{% for f in fetches %}<tr><td><a href="/f/{{ f.id }}">{{ f.fetched_at }}</a></td>
<td>{% if f.ok %}<span class="ok">OK</span>{% else %}<span class="ng">NG</span>{% endif %}{% if f.error %}<div class="ng">{{ f.error }}</div>{% endif %}</td>
<td>{{ f.raw_status or '-' }}・{{ f.raw_bytes|kb }}・{{ f.raw_ms or '-' }}ms</td><td>{{ f.dom_status or '-' }}・{{ f.dom_bytes|kb }}・{{ f.dom_ms or '-' }}ms</td>
<td>{{ f.xhr_count }} 件</td></tr>{% else %}<tr><td colspan="5" class="muted">まだ取っていません</td></tr>{% endfor %}
</table></div></div>"""
@app.get("/t/<int:tid>")
def target(tid):
    con = db.connect()
    t = target_or_404(con, tid)
    fetches = con.execute("""SELECT id, fetched_at, ok, error, raw_status, raw_bytes, raw_ms, dom_status, dom_bytes, dom_ms, xhr_count
        FROM fetches WHERE target_id=? ORDER BY fetched_at DESC""", (tid,)).fetchall()
    return page(t["label"] or t["url"], TARGET, t=t, fetches=fetches, intervals=INTERVALS)
FETCH = """
<div class="card"><h1>{{ f.fetched_at }} の回</h1><p><a href="/t/{{ t.id }}">← {{ t.label or t.url }}</a></p>
<table><tr><th></th><th>ステータス</th><th>大きさ</th><th>時間</th><th>見る</th></tr>
<tr><td>最初の HTML(file_get_contents と同じ)</td><td>{{ f.raw_status or '-' }}</td><td>{{ f.raw_bytes|kb }}</td><td>{{ f.raw_ms or '-' }}ms</td>
<td><a href="/f/{{ f.id }}/raw.txt">テキストで見る</a></td></tr>
<tr><td>JavaScript が動いたあとの DOM</td><td>{{ f.dom_status or '-' }}</td><td>{{ f.dom_bytes|kb }}</td><td>{{ f.dom_ms or '-' }}ms</td>
<td><a href="/f/{{ f.id }}/dom.txt">テキストで見る</a></td></tr></table>
<p><a href="/f/{{ f.id }}/diff">最初の HTML と動いたあとの DOM の違い</a>{% if prev %}・<a href="/f/{{ f.id }}/changes">前の回({{ prev.fetched_at }})からの変化</a>{% endif %}</p>
{% if f.error %}<p class="ng">{{ f.error }}</p>{% endif %}</div>
<div class="card"><h2>裏で読んでいた通信(xhr・fetch){{ xhrs|length }} 件</h2>
<p class="muted">ページが JavaScript で取りに行ったデータです。ここの URL を直接読めば、ブラウザーなしで取れることがあります。</p><div class="wrap"><table>
<tr><th>URL</th><th>ステータス</th><th>種類</th><th>大きさ</th></tr>
{% for x in xhrs %}<tr><td class="url">{{ x.method }} {% if x.has_body %}<a href="/x/{{ x.id }}">{{ x.url }}</a>{% else %}{{ x.url }}{% endif %}</td>
<td>{{ x.status }}</td><td>{{ x.content_type }}</td><td>{{ x.bytes|kb }}</td></tr>{% else %}<tr><td colspan="4" class="muted">ありません</td></tr>{% endfor %}
</table></div></div>"""
def fetch_or_404(con, fid):
    f = con.execute("SELECT * FROM fetches WHERE id=?", (fid,)).fetchone()
    if not f:
        abort(404)
    return f
@app.get("/f/<int:fid>")
def fetch_view(fid):
    con = db.connect()
    f = fetch_or_404(con, fid)
    t = target_or_404(con, f["target_id"])
    prev = con.execute("SELECT id, fetched_at FROM fetches WHERE target_id=? AND fetched_at<? ORDER BY fetched_at DESC LIMIT 1",
                       (t["id"], f["fetched_at"])).fetchone()
    xhrs = con.execute("SELECT id, url, method, status, content_type, bytes, body IS NOT NULL has_body FROM xhrs WHERE fetch_id=?", (fid,)).fetchall()
    return page(f"{f['fetched_at']} の回", FETCH, f=f, t=t, prev=prev, xhrs=xhrs)
def text(body):
    return Response(body, mimetype="text/plain", headers={"X-Content-Type-Options": "nosniff"})
@app.get("/f/<int:fid>/<kind>.txt")
def fetch_text(fid, kind):
    if kind not in ("raw", "dom"):
        abort(404)
    con = db.connect()
    f = fetch_or_404(con, fid)
    return text(db.unpack(f[f"{kind}_html"]))
@app.get("/x/<int:xid>")
def xhr_body(xid):
    con = db.connect()
    x = con.execute("SELECT body FROM xhrs WHERE id=?", (xid,)).fetchone()
    if not x:
        abort(404)
    return text(db.unpack(x["body"]))
def lines(html):
    # 1 行に詰まった HTML でも違いが読めるよう、タグの区切りで行を分ける
    return [s for s in re.sub(r">\s*<", ">\n<", html).splitlines() if s.strip()]
DIFF = """<div class="card"><h1>{{ title }}</h1><p><a href="/f/{{ fid }}">← この回に戻る</a>・<span class="add">+ 増えた行</span>・<span class="rm">− なくなった行</span>({{ n }} 行の違い{% if cut %}・最初の 3000 行だけ表示{% endif %})</p>
<pre>{% for l in out %}{% if l.startswith('+') and not l.startswith('+++') %}<span class="add">{{ l }}</span>{% elif l.startswith('-') and not l.startswith('---') %}<span class="rm">{{ l }}</span>{% else %}{{ l }}{% endif %}
{% else %}違いはありません{% endfor %}</pre></div>"""
def diff_page(title, fid, a, b, an, bn):
    d = list(difflib.unified_diff(lines(a), lines(b), an, bn, lineterm="", n=1))
    return page(title, DIFF, title=title, fid=fid, out=d[:3000], n=len(d), cut=len(d) > 3000)
@app.get("/f/<int:fid>/diff")
def raw_vs_dom(fid):
    con = db.connect()
    f = fetch_or_404(con, fid)
    return diff_page("最初の HTML と動いたあとの DOM の違い", fid, db.unpack(f["raw_html"]), db.unpack(f["dom_html"]), "最初の HTML", "動いたあとの DOM")
@app.get("/f/<int:fid>/changes")
def changes(fid):
    con = db.connect()
    f = fetch_or_404(con, fid)
    p = con.execute("SELECT * FROM fetches WHERE target_id=? AND fetched_at<? ORDER BY fetched_at DESC LIMIT 1",
                    (f["target_id"], f["fetched_at"])).fetchone()
    if not p:
        abort(404)
    return diff_page("前の回からの変化(動いたあとの DOM)", fid, db.unpack(p["dom_html"]), db.unpack(f["dom_html"]), p["fetched_at"], f["fetched_at"])
if __name__ == "__main__":
    app.run(host=HOST, port=PORT, threaded=True)
手順 D:画面を立ち上げて、1 件取ってみる
cd ~/scraper
chmod 700 fetcher.py app.py
nohup venv/bin/python app.py > data/app.log 2>&1 &    # 画面を立ち上げる(裏で動き続ける)
PC のブラウザーで http://ラズパイの IP アドレス:8090/ を開きます(第 3 回で決めた IP アドレス)。「URL を登録する」に、次の 2 つを登録してみます。
- URL:
https://quotes.toscrape.com/js/・この部品が出るまで待つ:.quote - URL:
https://quotes.toscrape.com/scroll・この部品が出るまで待つ:.quote
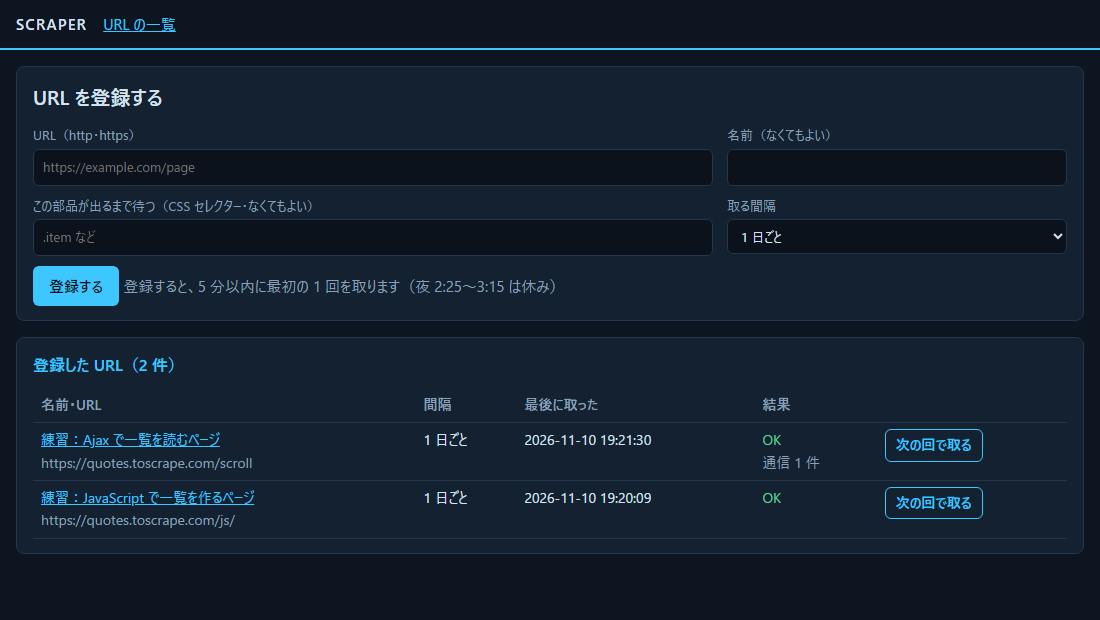
次の手順 E の cron を設定すれば 5 分以内に取りますが、すぐに試すなら手動で動かします。--id の数字は、登録した順の番号です(1 件目が 1)。
cd ~/scraper && venv/bin/python fetcher.py --id 1
tail -n 1 data/fetch.log
2026-11-10 19:14:29 OK id=1 fetch=1 raw=200/634ms dom=200/1911ms xhr=0 https://quotes.toscrape.com/js/raw が最初に届いた HTML、dom が JavaScript が動いたあとの HTML です。OK と出れば成功です。
手順 E:自動で動くようにする
crontab -e を開いて、最後に次の 2 行を足します。1 行目で 5 分ごとに取得のプログラムを起こし、2 行目でラズパイを再起動したときに画面を立ち上げます。
*/5 * * * * cd $HOME/scraper && venv/bin/python fetcher.py >/dev/null 2>&1
@reboot cd $HOME/scraper && sleep 30 && venv/bin/python app.py >> data/app.log 2>&1- 5 分ごとに起きても、取る時期が来た URL がなければ、何もせずにすぐ止まります。Chromium は、取る URL があるときだけ立ち上がります。
- 前の回がまだ動いていたら、次の回は何もしません(同じ時間に 2 つ動いて、メモリーが足りなくなるのを防ぐ)。
取ったものを見る
一覧の名前をクリックすると取った回の一覧が、日時をクリックするとその回の詳しい画面が表示されます。
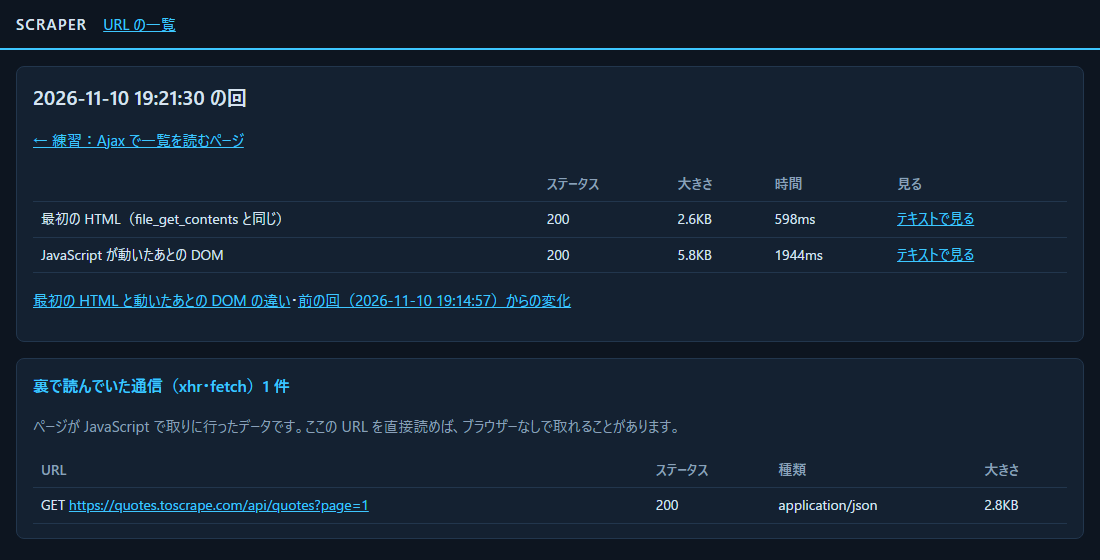
- テキストで見る:取った HTML を、そのままのテキストで表示します。この画面の中では、取った HTML を HTML として表示しません(相手のページのスクリプトが、自分の画面で動かないようにするため)。
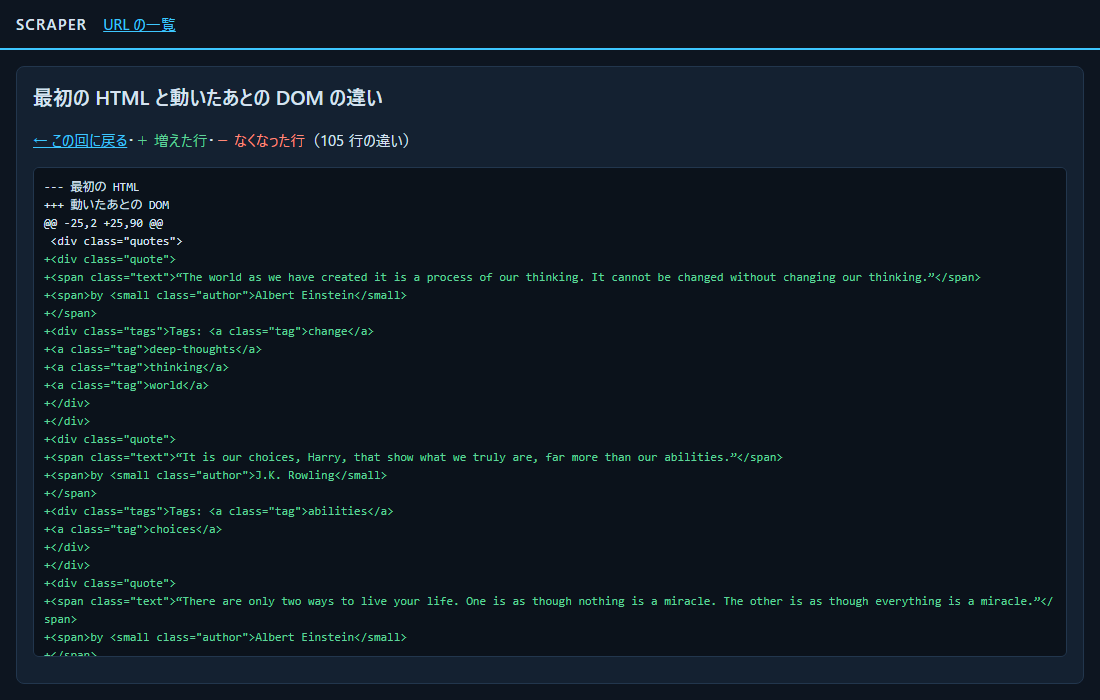
- 最初の HTML と動いたあとの DOM の違い:JavaScript が足した部分が、緑の行で表示されます。
- 前の回からの変化:2 回目からは、前の回とくらべて変わった所も見られます(価格や在庫の変化を見るときに便利です)。
- 裏で読んでいた通信:ページが JavaScript で取りに行ったデータの URL です。クリックすると、内容(JSON など)が表示されます。
試した結果
| ページ | 結果 |
|---|---|
| /js/(JavaScript で一覧を作る) | 最初の HTML:名言 0 件 動いたあとの HTML:10 件 |
| /scroll(Ajax で一覧を読む) | 最初の HTML:0 件 動いたあとの HTML:10 件・裏の通信 1 件(/api/quotes?page=1 の JSON) |
- file_get_contents と同じ取り方では、どちらも 0 件でした。ブラウザーで開いたときだけ、一覧が出てきます。
- /scroll では、ページが裏で読んでいる API の URL が分かりました。この URL を直接読めば、ブラウザーを使わずに、軽く速く取れることもあります(ここでも利用規約と robots.txt は守ります)。
- 時間:1 件あたり約 8 秒(最初に届いた HTML 0.6 秒・Chromium で開いて待つ 1.9 秒・Chromium の起動など)。Chromium は、1 回の中で 2 件目からは起動しないので、続けて取るほど 1 件あたりは短くなります。
- メモリー:取っているあいだ、ラズパイのメモリーの使用が約 170MB 増えました(Pi 3 の 1GB で、ほかの処理と一緒に動いています)。
つまずきやすい所
- 「Host system is missing dependencies」と出る:手順 A の部品が足りません。表示された名前を
sudo apt-get install -yでインストールします。 - 画面が開かない:
tail data/app.logでエラーを見ます。ほかのソフトが 8090 を使っているときは、app.py のSCRAPER_PORTを変えます。 - NG で「robots.txt で取らないように決められている」:そのサイトは、自動で取らないでほしいと決めています。取らないでください。
- 「止めている」と表示される:403・429 などが返ったので、6 時間止めています。「次の回で取る」を押しても、止めている期間は取りに行きません。間隔を長くするか、そのサイトは取らないようにします。
- 一覧が入っていないのに OK になる:一覧が出るのを待ちきれていません。「この部品が出るまで待つ」に、取りたい部品の CSS セレクター(例:
.item)を入力します。
セキュリティの考え方
- 画面は、家の LAN の中からだけ開く前提です。ルーターでポートを開けて、外から開けるようにはしないでください(Flask の画面は、インターネットに出す作りではありません)。
- 登録・無効にする・消すは POST だけで受け付け、この画面から送ったものでなければ断ります(よそのページから勝手に登録されないようにするため)。
- 取った HTML は、テキストとしてだけ表示します。
分からないときは、このページを AI に渡してください
このページの URL を AI(Claude など)に渡して「この手順を手伝って」と頼めば、一緒に進めてくれます。第 4 回の形にしてあれば、AI がラズパイのログを直接見て進められます。頼み方の例です。
- 「(このページの URL)の環境で、取った HTML から商品名と価格だけを取り出して、表で見られるようにしたい」
- 「(このページの URL)の手順 D で NG になった。data/fetch.log はこうだった:(ログを貼る)」
まとめ
この記事でできるようになったこと
- 画面から URL を登録すると、ラズパイが決めた間隔で完全自動で取得して保存する
- file_get_contents では取れない、JavaScript が作った一覧まで取れる
- ページが裏で読んでいるデータ(JSON)の場所と内容が分かる
PC を起動しておかなくても、ラズパイが 24 時間、決まった間隔で取りに行ってくれます。「ソースに一覧が出てこない」と困ったときは、まずこの環境に URL を登録して、裏の通信を見てみてください。
次に読む
- 基本の環境づくり(第 1〜9 回)のはじめ:第 1 回「ラズパイを始める:買う物をそろえる」
- ほかの使い方:ラズパイでできること